Accès
Filtrer
Quels sites ou catégories sont autorisés ?
Impact décision : Réduit les usages non souhaités ou risqués.

Guide clair pour distinguer proxy et reverse proxy, comprendre leur place dans le réseau et choisir le bon outil.

Un proxy et un reverse proxy sont deux intermédiaires réseau, mais ils ne protègent pas le même côté. Le proxy se place plutôt devant les utilisateurs qui sortent vers Internet. Le reverse proxy se place plutôt devant les serveurs qui reçoivent les visiteurs. Cette inversion explique presque toutes les différences.
Pour approfondir ce point, consultez adresse IP privée publique, qui traite plus précisément de adresse ip privée ou publique, comment faire la différence.
Si vous débutez, retenez une image simple : le proxy parle à Internet pour un utilisateur ; le reverse proxy parle aux serveurs pour un visiteur. Dans les deux cas, l’intermédiaire peut filtrer, journaliser, cacher, répartir ou sécuriser le trafic. Mais son rôle métier n’est pas le même.
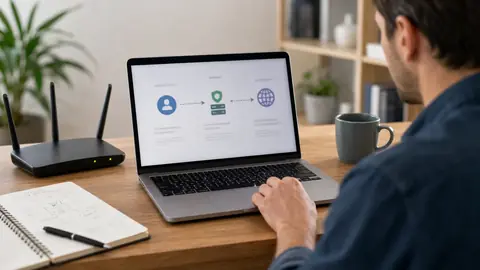
Un serveur proxy reçoit les requêtes d’un poste, les relaie vers Internet, puis renvoie la réponse. Pour le serveur distant, l’interlocuteur visible peut être le proxy plutôt que l’ordinateur de l’utilisateur. Cette position permet de contrôler le trafic sortant.
Dans une entreprise, un proxy peut bloquer certains sites, appliquer une politique de navigation, conserver des journaux, authentifier les utilisateurs ou mettre en cache des contenus fréquemment demandés. Il devient un point d’observation et de décision entre le réseau interne et l’extérieur.
Un proxy peut être configuré explicitement dans le navigateur ou le système. Il peut aussi être transparent dans certaines architectures, mais ce choix demande une conception réseau plus stricte. Dans tous les cas, il faut éviter de le présenter comme une solution magique d’anonymat : il voit beaucoup de trafic et doit être administré avec rigueur.
Ses usages sont surtout centrés sur les utilisateurs et le réseau interne.
Quels sites ou catégories sont autorisés ?
Impact décision : Réduit les usages non souhaités ou risqués.
Qui accède à quoi et quand ?
Impact décision : Aide au diagnostic et à la conformité interne.
Certains contenus reviennent-ils souvent ?
Impact décision : Peut réduire la bande passante consommée.
Chaque utilisateur doit-il être reconnu ?
Impact décision : Permet une politique différente selon les profils.
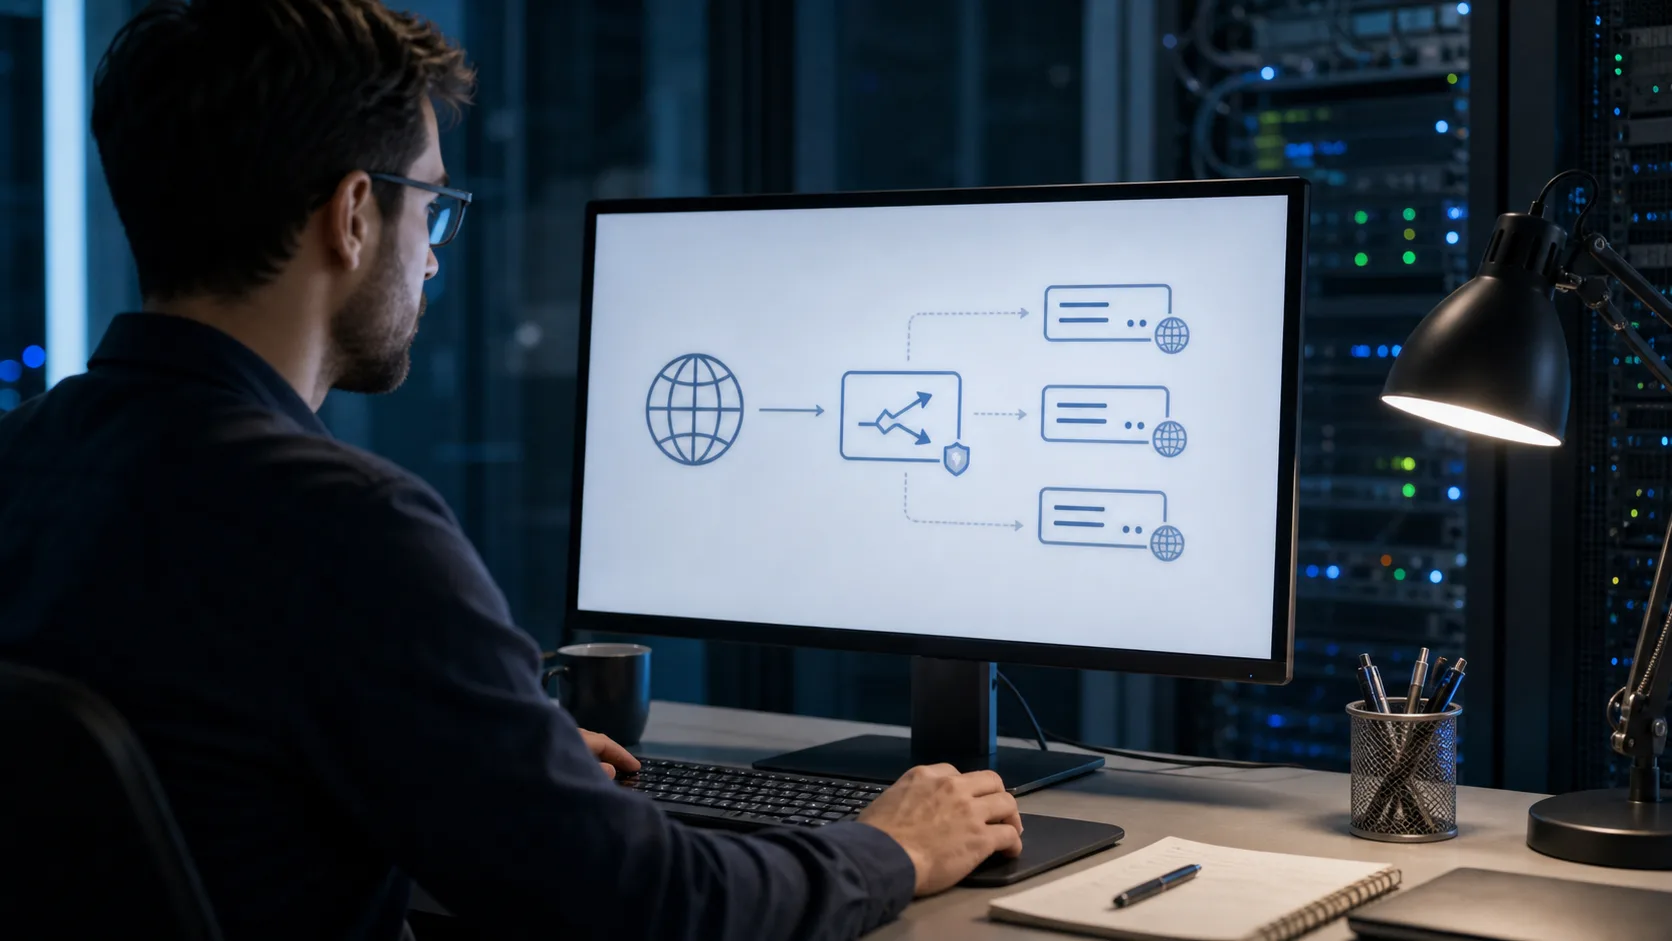
Un reverse proxy se place devant une ou plusieurs applications. Le visiteur contacte le reverse proxy, qui décide ensuite vers quel serveur interne transmettre la requête. Pour l’utilisateur, l’application paraît avoir une seule porte d’entrée. En interne, l’architecture peut être beaucoup plus distribuée.
Ce rôle est central pour les sites modernes : terminaison TLS, routage par domaine ou chemin, compression, cache, répartition de charge, protection de certains backends, limitation de débit, règles de sécurité. Un reverse proxy bien configuré évite d’exposer directement les serveurs applicatifs.
Dans une petite équipe, NGINX, Caddy, Traefik ou HAProxy peuvent jouer ce rôle selon le besoin. Dans une infrastructure plus grande, le reverse proxy devient souvent une couche complète d’entrée, parfois combinée avec un load balancer, un pare-feu applicatif ou une plateforme d’orchestration.
Pour approfondir ce point, consultez SIRET et SIREN, la différence à retenir, qui traite plus précisément de siret et siren, la différence à retenir sans se tromper.
Pour ne plus les confondre, posez cette question : qui est protégé ou organisé par l’intermédiaire ? Si ce sont les utilisateurs internes qui sortent vers Internet, vous parlez plutôt d’un proxy. Si ce sont les serveurs internes qui reçoivent du trafic depuis Internet, vous parlez plutôt d’un reverse proxy.
| Critère | Proxy | Reverse proxy |
|---|---|---|
| Côté protégé | Clients et utilisateurs | Applications et serveurs |
| Sens principal | Sortant vers Internet | Entrant depuis Internet |
| Cas courant | Filtrage web entreprise | Exposer un site ou une API |
| Outils fréquents | Squid, proxy web, passerelle | NGINX, HAProxy, Traefik |
Exposer directement une application oblige chaque serveur à gérer HTTPS, certificats, règles de sécurité, logs publics, montée en charge et erreurs réseau. Avec un reverse proxy, ces responsabilités peuvent être centralisées. Les backends restent plus simples et ne sont pas forcément visibles depuis Internet.
Le reverse proxy facilite aussi les déploiements. Il peut envoyer /api vers un service, /admin vers un autre, ou répartir les requêtes entre plusieurs instances d’une même application. En cas de maintenance, il peut retirer un backend du trafic sans couper toute la plateforme.
Cette puissance a un prix : une mauvaise configuration peut casser les en-têtes, les IP réelles, les redirections HTTPS, les websockets ou les limites de taille. Les en-têtes comme X-Forwarded-For et Forwarded doivent être compris, pas copiés aveuglément.
Le bon choix dépend du flux que vous voulez maîtriser.
Proxy
Filtrer et tracer les sorties des utilisateurs.
Reverse proxy
Recevoir le trafic et protéger les serveurs.
Reverse proxy
Distribuer les requêtes entre plusieurs backends.
Les deux
Le sens du trafic détermine le type exact.
Le premier piège est de croire qu’un proxy rend automatiquement anonyme. Un proxy peut masquer une adresse vis-à-vis d’un serveur distant, mais il peut aussi journaliser l’utilisateur, les sites visités et les horaires. La confidentialité dépend de qui contrôle le proxy et de sa politique de logs.
Pour approfondir ce point, consultez portage salarial, qui traite plus précisément de portage salarial, comprendre le statut avant de signer une mission.
Le deuxième piège est de confondre reverse proxy et pare-feu. Un reverse proxy peut filtrer et limiter, mais il ne remplace pas toute la sécurité réseau. Il complète la défense : TLS, routage, restrictions, logs, éventuellement règles applicatives, mais il doit s’intégrer dans une architecture plus large.
Le troisième piège est d’oublier l’observabilité. Quand un intermédiaire se place entre client et serveur, les erreurs changent de forme. Une panne peut venir du proxy, du DNS, du certificat, du backend, du routage ou d’un timeout. Sans logs propres, le diagnostic devient pénible.
Un proxy ou un reverse proxy modifie souvent la façon dont les adresses IP apparaissent dans les journaux. Côté proxy sortant, les sites distants peuvent surtout voir l’adresse du proxy. Côté reverse proxy, l’application interne peut voir l’adresse de l’intermédiaire au lieu de celle du visiteur réel si les en-têtes ne sont pas transmis correctement.
Cette nuance est importante pour la sécurité, l’analyse d’audience, la détection d’abus et le support. Si votre application bloque une IP, génère un journal d’erreur ou limite les tentatives de connexion, elle doit comprendre l’adresse client réelle ou au moins savoir qu’elle travaille derrière un intermédiaire.
Mais transmettre ces en-têtes demande de la prudence. Un serveur ne doit pas faire confiance à n’importe quel X-Forwarded-For envoyé depuis Internet. Il doit faire confiance uniquement au reverse proxy contrôlé par l’infrastructure. Sinon, un client peut falsifier des informations et brouiller les journaux.
Pour approfondir ce point, consultez redirection de port domotique, qui traite plus précisément de redirection de port en domotique sans exposer toute la maison.
Pour un proxy sortant classique, Squid reste une référence quand le besoin porte sur le cache, le filtrage ou le contrôle de navigation. Pour un reverse proxy web, NGINX, Caddy ou Traefik sont souvent simples à intégrer. Pour la répartition de charge avancée et les très forts trafics, HAProxy est un choix robuste.
Le meilleur outil n’est pas toujours le plus puissant. Une petite équipe gagne parfois à choisir une configuration lisible, bien documentée, plutôt qu’un empilement de règles difficile à maintenir. Un reverse proxy qui personne ne comprend devient vite un point de panne.
Avant de choisir, écrivez trois choses : le flux à gérer, le niveau de sécurité attendu et les personnes qui devront maintenir l’outil. Cette étape évite de déployer un produit pensé pour une plateforme complexe quand un simple reverse proxy HTTPS suffisait.
Imaginez une application avec un site public, une API et un tableau d’administration. Le reverse proxy peut recevoir toutes les requêtes sur le domaine principal, envoyer /api vers le service API, garder le site public sur un autre serveur et restreindre /admin à certaines adresses ou à une couche d’authentification.
Dans le même réseau, un proxy sortant peut servir aux postes internes de l’équipe : filtrage web, journalisation, contrôle des téléchargements et politiques différentes selon les profils. Les deux systèmes coexistent, mais ils ne gèrent pas la même direction du trafic.
Pour approfondir ce point, consultez LAN MAN WAN PAN, qui traite plus précisément de lan, man, wan, pan : comprendre les différences simplement.
Cette séparation clarifie l’architecture : le proxy sortant encadre les usages des collaborateurs ; le reverse proxy protège et organise les services publiés. Mélanger les deux dans les explications crée souvent des erreurs de conception.
Un proxy ou un reverse proxy réduit l’exposition, mais il ne corrige pas une application vulnérable, un mot de passe faible ou une mauvaise politique de mise à jour. Il faut donc le voir comme une couche de contrôle, pas comme une garantie absolue.
Pour un reverse proxy, vérifiez les certificats, les redirections HTTPS, les limites de taille, les timeouts et les règles d’accès. Pour un proxy sortant, vérifiez les logs, les exceptions, les accès administrateur et les règles de filtrage. Dans les deux cas, documentez les choix.
Une configuration simple mais documentée évite beaucoup de pannes.
Un proxy accompagne les utilisateurs vers Internet. Un reverse proxy accompagne les requêtes Internet vers vos applications. Tous deux sont des intermédiaires, mais leur place dans le flux change leur mission, leurs risques et leurs outils.
Pour choisir correctement, partez du sens du trafic et du problème à résoudre. Vous voulez encadrer la sortie web d’un réseau interne : proxy. Vous voulez publier et protéger une application : reverse proxy. Le reste n’est qu’une question d’architecture et de configuration.
Pour approfondir ce point, consultez masque de sous reseau IPv4, qui traite plus précisément de masque de sous-reseau ipv4 : calculer un cidr sans se tromper.
À lire aussi
Le rôle réel d'un serveur OPC dans une architecture industrielle, avec les points à vérifier avant de l'exposer à des clients ou logiciels métier.
 · ·5 min

Windows Admin Center centralise l'administration de serveurs Windows dans un navigateur. Voici quand l'utiliser, comment le déployer et ce qu'il ne remplace pas.
· ·5 min 
Guide prudent pour désactiver temporairement Microsoft Defender, vérifier un faux positif, éviter les contournements permanents et réactiver la protection.
· ·9 min 
DNS Cloudflare: comprendre 1.1.1.1, les variantes filtrantes, IPv6, DNS chiffré, configuration routeur ou poste et vérifications utiles.
· ·9 min 
Windows Server 2019 reste exploitable dans certains contextes, mais support, sécurité, sauvegardes et migration doivent être pilotés avant 2029.
· ·6 min 
Guide pratique pour changer les DNS sur Windows 11 sans casser le réseau: paramètres, routeur, VPN, vérifications et erreurs fréquentes.
· ·8 min Un condensé de veille télécom, cloud, sécurité et outils numériques pour décider plus vite, sans bruit inutile.
Aucun spam. Désinscription en un clic.