Site lent
Commencer par traceroute puis comparer avec mtr si la lenteur varie.

Un guide pratique pour utiliser traceroute sous Linux, lire les sauts réseau et éviter les erreurs de diagnostic.
Traceroute sous Linux sert à visualiser le chemin suivi par des paquets entre une machine et une destination. C’est un outil de diagnostic précieux quand un site répond lentement, qu’un VPN décroche, qu’un service distant devient instable ou qu’un opérateur demande une preuve avant d’ouvrir un ticket. Il ne donne pas toute la vérité du réseau, mais il donne une première carte exploitable, surtout quand le chemin réseau devient suspect.
La difficulté vient de son apparente simplicité. On lance une commande, on obtient des lignes, des temps et parfois des étoiles. Beaucoup concluent trop vite : “le routeur 6 est en panne”, “le fournisseur bloque”, “le serveur final ne répond pas”. Or un traceroute montre une réaction à des paquets de test, pas forcément le trajet exact de toute application métier.
Bien lu, c’est un outil d’orientation ; mal lu, c’est une machine à faux diagnostics, surtout quand la sortie est sortie de son contexte.
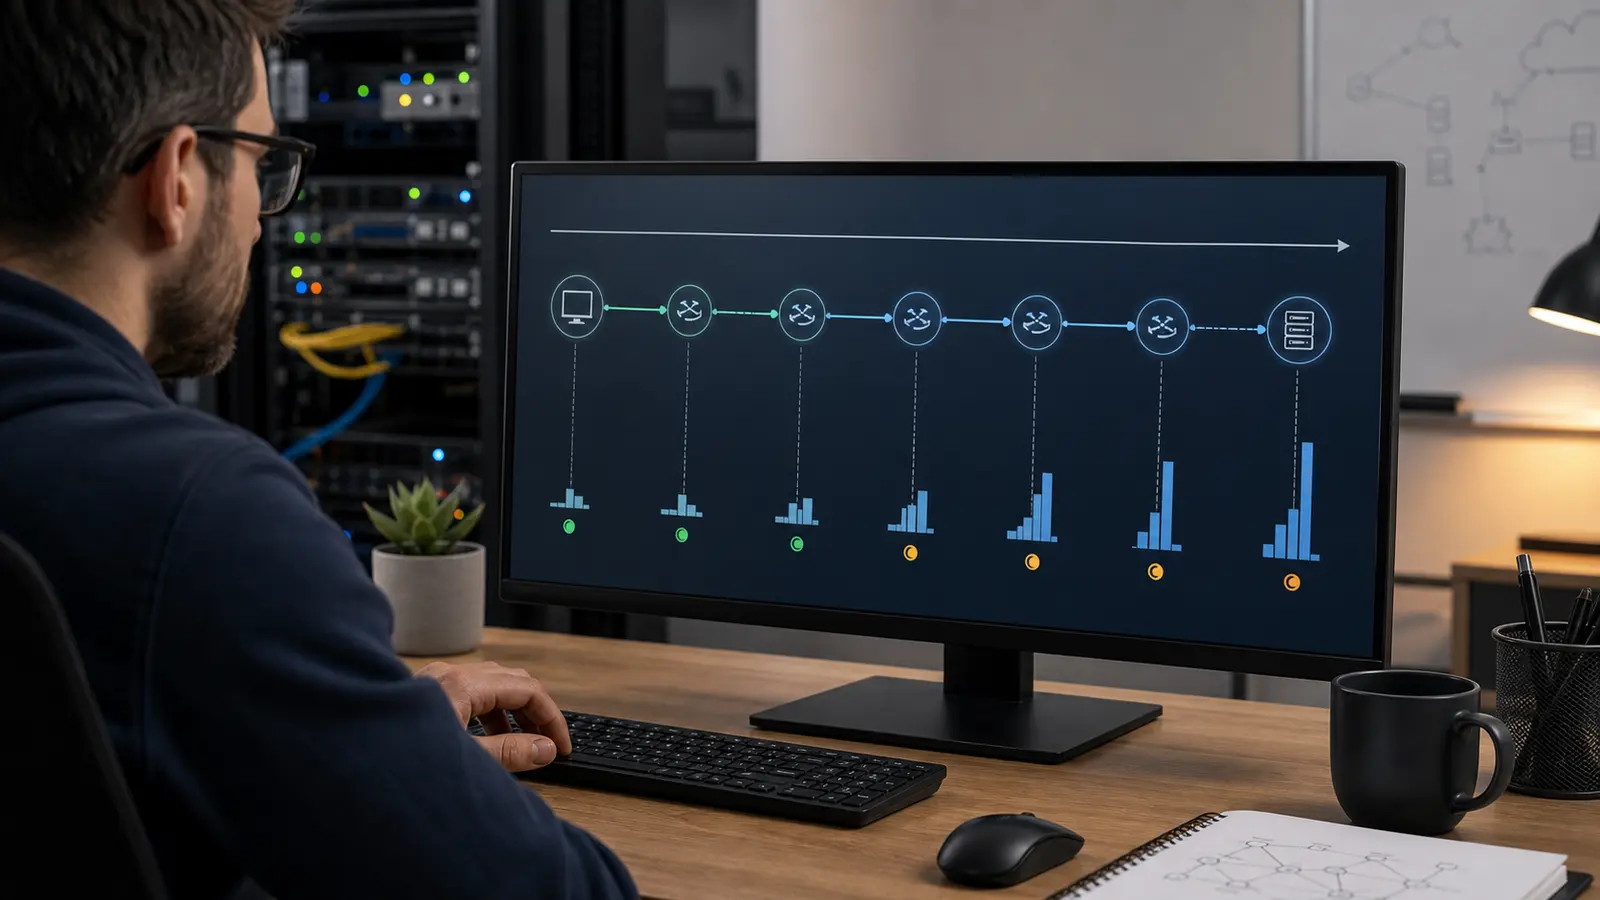
Traceroute exploite le principe du TTL, le “time to live” des paquets IP. Chaque routeur traversé décrémente cette valeur. Quand elle arrive à zéro, l’équipement peut renvoyer un message indiquant que le paquet a expiré. En augmentant progressivement le TTL, traceroute tente donc de faire répondre les équipements rencontrés sur le chemin.
Cette mécanique donne une série de sauts, souvent appelés hops. Chaque ligne correspond à une étape possible du trajet et affiche généralement un ou plusieurs temps de réponse. Ces temps ne mesurent pas seulement la latence applicative : ils mesurent la réponse de l’équipement au type de paquet utilisé par le test. C’est pour cela qu’un traceroute peut sembler inquiétant alors que l’application reste joignable, ou paraître propre alors qu’un port précis est filtré plus loin.
Ce détail change tout. Un routeur peut transmettre correctement le trafic client tout en répondant lentement, rarement ou jamais aux paquets de diagnostic. Un saut silencieux n’est donc pas automatiquement un saut défaillant.
Selon la distribution Linux, la commande traceroute n’est pas toujours installée par défaut.
On peut la trouver dans les dépôts classiques, tandis que tracepath est parfois disponible plus facilement. Les deux outils aident à comprendre un chemin réseau, mais ils ne se comportent pas exactement de la même manière. Cette différence compte dans un environnement professionnel : un script de support, une documentation interne ou une procédure opérateur doit préciser l’outil attendu, sinon les sorties comparées ne racontent pas tout à fait la même histoire.
Traceroute offre davantage d’options : méthode UDP, ICMP, TCP, port cible, nombre de sauts, délai d’attente, résolution DNS ou affichage numérique. Tracepath est plus simple et utile pour repérer un chemin ainsi que certains éléments de MTU, mais il laisse moins de contrôle au technicien.
Le choix dépend du contexte : exploration rapide, diagnostic précis ou preuve à transmettre à un support externe.
La commande doit répondre au symptôme observé.
Commencer par traceroute puis comparer avec mtr si la lenteur varie.
Tester une méthode TCP vers le port réellement utilisé.
Utiliser tracepath ou traceroute numérique pour une première carte.
| Outil | Usage | Point fort |
|---|---|---|
| traceroute | Diagnostic contrôlé | Options nombreuses, modes UDP/ICMP/TCP |
| tracepath | Lecture rapide du chemin | Simple, souvent disponible, utile pour MTU |
| ping | Test de joignabilité | Latence globale et perte simple |
| mtr | Suivi dans le temps | Vue continue des pertes et latences par saut |
Commencez par lire la ligne, pas par chercher le coupable : l’ordre, la stabilité et la suite des sauts comptent davantage qu’un seul chiffre isolé.
Une ligne traceroute affiche en général un numéro de saut, un nom ou une adresse IP, puis plusieurs mesures. Si les trois mesures sont proches, le saut semble stable pendant le test. Si elles varient fortement, cela peut indiquer de la congestion, une réponse dépriorisée ou simplement un équipement qui ne consacre pas beaucoup de ressources au diagnostic.
Les étoiles sont le piège le plus courant. Elles indiquent que traceroute n’a pas reçu de réponse exploitable dans le délai prévu. Cela peut venir d’un filtrage, d’un pare-feu, d’un routeur configuré pour ne pas répondre, d’un chemin asymétrique ou d’un vrai problème. Les étoiles seules ne suffisent pas à conclure, car certains équipements transmettent normalement le trafic tout en refusant de répondre aux sondes de diagnostic, surtout sur des réseaux opérateurs ou fortement sécurisés.
La règle terrain est simple : regardez ce qui se passe après le saut silencieux. Si la suite répond normalement, le saut est peut-être seulement muet ; si la suite disparaît aussi, la zone devient plus intéressante.
Le protocole choisi change la question posée au réseau, donc la conclusion possible.
Sous Linux, traceroute utilise historiquement des paquets UDP par défaut dans beaucoup de cas, mais il peut aussi travailler avec ICMP ou TCP selon les options, les droits et les paquets installés. Ce choix compte parce que les pare-feu, routeurs et fournisseurs ne traitent pas tous les protocoles de diagnostic de la même manière. Un résultat propre en UDP ne prouve donc pas forcément que le flux applicatif passe, et un résultat filtré en ICMP ne prouve pas forcément une coupure.
Un traceroute UDP peut échouer là où un traceroute TCP vers un port applicatif passe. À l’inverse, un traceroute ICMP peut être filtré alors que l’application fonctionne parfaitement. Pour diagnostiquer un service HTTPS, tester un traceroute TCP vers le port 443 peut parfois être plus parlant qu’un test générique.
Ne changez pas d’option au hasard. Notez la méthode utilisée, sinon deux techniciens peuvent comparer des résultats qui ne mesurent pas exactement la même chose.
Le protocole doit suivre la question posée.
Classique
Utile pour une première lecture, mais parfois filtré.
Lisible
Proche de ping, dépend des politiques ICMP.
Applicatif
Intéressant pour tester un port comme 443 ou 25.
Suivi
À utiliser quand le problème est intermittent.
Un seul traceroute pris à une heure inconnue vaut peu. Pour qu’il devienne une preuve utile, il faut le répéter depuis plusieurs points : poste utilisateur, serveur interne, VPN, autre accès Internet ou machine cloud de référence. Si tous les tests convergent vers la même zone, la piste réseau devient plus solide.
Il faut aussi dater les mesures. Un incident de routage peut durer dix minutes, une saturation peut apparaître seulement en heure de pointe, un filtrage peut concerner un port précis. Un résultat sans heure, sans source et sans destination complète perd une grande partie de sa valeur opérationnelle.
Documenter le contexte évite les échanges stériles avec l’opérateur et accélère la première réponse utile.
Traceroute ne voit pas toujours le chemin retour. Or Internet et les réseaux opérateurs peuvent être asymétriques : l’aller et le retour ne passent pas forcément par les mêmes équipements. Une latence ou une perte apparente sur le chemin aller ne dit donc pas tout de l’expérience réelle de l’application. C’est une limite importante dans les architectures multi-opérateurs, les accès VPN, les interconnexions cloud et les sites qui utilisent plusieurs chemins de sortie.
Autre limite : certains routeurs limitent volontairement les réponses de diagnostic. Ils continuent à transmettre le trafic, mais répondent lentement aux paquets qui leur sont destinés. C’est une protection courante. Elle explique pourquoi une latence élevée sur un saut intermédiaire n’est pas forcément un problème si les sauts suivants restent cohérents.
Enfin, le DNS peut brouiller la lecture. Les noms de routeurs donnent parfois des indices de ville, d’opérateur ou de réseau, mais ils peuvent être imprécis, obsolètes ou trompeurs. Pour une analyse sérieuse, gardez aussi les adresses IP numériques.
Commencez par vérifier si le problème est local. Testez la passerelle, un site connu, puis la destination. Si seule la destination pose problème, lancez traceroute depuis le poste concerné et depuis un autre accès. Cette comparaison permet de distinguer une panne locale, un problème de fournisseur ou une difficulté côté service distant.
Ensuite, cherchez le premier changement net : arrêt complet des réponses, hausse durable de latence, saut récurrentement silencieux, divergence entre deux accès. Le but n’est pas de pointer un équipement avec certitude, mais de délimiter la zone probable pour orienter l’escalade.
Si l’incident touche une application critique, ajoutez un test orienté port. Pour HTTPS, par exemple, un test TCP vers 443 est plus proche de l’usage réel qu’un simple traceroute par défaut. La sortie sera plus utile pour le support réseau, surtout si elle est accompagnée d’un horodatage et d’une description claire du symptôme.
La commande de base reste simple : lancer traceroute vers un nom de domaine ou une adresse IP. Pour un diagnostic plus propre, ajoutez parfois l’option qui désactive la résolution DNS afin d’éviter de confondre lenteur réseau et lenteur de résolution. Cette sortie numérique est moins agréable à lire, mais plus stable pour comparer deux mesures.
Quand le problème concerne un service web, un test TCP vers le port 443 peut être plus utile qu’un test par défaut. Il ne garantit pas que l’application fonctionne, mais il rapproche le diagnostic du trafic réel. À l’inverse, pour un premier état des lieux, tracepath peut suffire et permet souvent d’obtenir une lecture rapide sans multiplier les options.
Le plus important est de conserver la commande exacte utilisée. Une capture d’écran sans commande, sans heure et sans machine source oblige le support à deviner. Une sortie brute bien annotée permet au contraire de comparer les résultats et de reproduire le test dans les mêmes conditions.
traceroute exemple.com
traceroute -n exemple.com
traceroute -T -p 443 exemple.com
tracepath exemple.comLe chemin réseau n’est pas toujours la cause principale.
Commencer par DNS et résolution locale avant le chemin IP.
Tester le service ou le port visé, pas seulement la route.
Préférer mtr ou supervision continue pour voir la durée.
Traceroute n’est pas l’outil prioritaire si l’incident vient d’une erreur DNS, d’un certificat expiré, d’une authentification applicative ou d’un service arrêté. Dans ces cas, il peut montrer un chemin réseau parfaitement correct alors que l’utilisateur reste bloqué. Le diagnostic doit donc commencer par le symptôme : résolution du nom, connexion au port, réponse applicative, puis seulement chemin réseau.
Il n’est pas non plus idéal pour les incidents très intermittents. Une photographie ponctuelle peut tomber entre deux pertes de paquets et donner l’impression que tout va bien. Pour ces situations, mtr, les logs applicatifs, les métriques opérateur et la supervision continue donnent une meilleure base de discussion.
Enfin, traceroute peut être trompeur dans les environnements cloud, CDN ou réseaux très filtrés. Les chemins changent, les réponses sont limitées et l’adresse finale ne représente pas toujours l’infrastructure complète. Il reste utile, mais comme une pièce du dossier, pas comme le dossier entier.
Traceroute sous Linux est un excellent outil pour comprendre un chemin réseau, mais il demande de la prudence. Il montre des réponses de diagnostic, pas une vérité absolue sur toute la circulation applicative. Sa force est de donner une direction, pas de produire un verdict automatique.
Pour l’utiliser correctement, regardez les sauts dans leur ensemble, notez la méthode utilisée, comparez plusieurs sources et croisez les résultats avec ping, tracepath, mtr ou un test TCP. Le bon diagnostic réseau n’est pas celui qui accuse le plus vite, mais celui qui réduit méthodiquement les hypothèses.
À lire aussi
Guide prudent pour désactiver temporairement Microsoft Defender, vérifier un faux positif, éviter les contournements permanents et réactiver la protection.
 · ·9 min
DNS Cloudflare: comprendre 1.1.1.1, les variantes filtrantes, IPv6, DNS chiffré, configuration routeur ou poste et vérifications utiles.
· ·9 min 
Windows Server 2019 reste exploitable dans certains contextes, mais support, sécurité, sauvegardes et migration doivent être pilotés avant 2029.
· ·6 min 
Guide pratique pour changer les DNS sur Windows 11 sans casser le réseau: paramètres, routeur, VPN, vérifications et erreurs fréquentes.
· ·8 min 
Un chemin de câble organise et protège les câbles, mais le bon choix dépend de la charge, du lieu, de la maintenance et de la séparation des réseaux.
· ·5 min 
Un guide opérationnel pour concevoir un réseau PME lisible, sécurisé et maintenable sans empiler du matériel inutile.
· ·10 min Un condensé de veille télécom, cloud, sécurité et outils numériques pour décider plus vite, sans bruit inutile.
Aucun spam. Désinscription en un clic.