Retrouver un Skyblog avec Wayback Machine, ce qui marche encore
Wayback Machine peut aider à retrouver un ancien Skyblog, mais seulement si l'URL a été capturée. Voici la méthode et les limites à connaître.
2 septembre 20265 min
Utiliser Wayback Machine pour un Skyblog peut marcher, mais pas comme une recherche Google classique. L’outil retrouve surtout des captures d’anciennes URL. Si vous avez le pseudo, une adresse du type ancien blog Skyrock ou un lien partagé à l’époque, vos chances augmentent nettement.
Depuis la fermeture de Skyblog, le réflexe utile consiste donc à reconstituer l’adresse, tester plusieurs variantes, puis vérifier les captures disponibles. La méthode demande parfois quelques essais, car toutes les pages, images et dates n’ont pas été archivées. Une lettre oubliée, un tiret ou une ancienne extension peut suffire à changer le résultat.
En bref
✓Wayback Machine fonctionne mieux avec une ancienne URL précise qu’avec un simple nom de blog.
✓Les captures peuvent contenir la page d’accueil sans forcément conserver toutes les photos.
✓Les anciennes adresses Skyrock et Skyblog doivent parfois être testées séparément.
✓La collecte patrimoniale de la BnF existe, mais son accès n’est pas le même qu’un moteur public.
Wayback Machine et Skyblog : que faire en premier ?
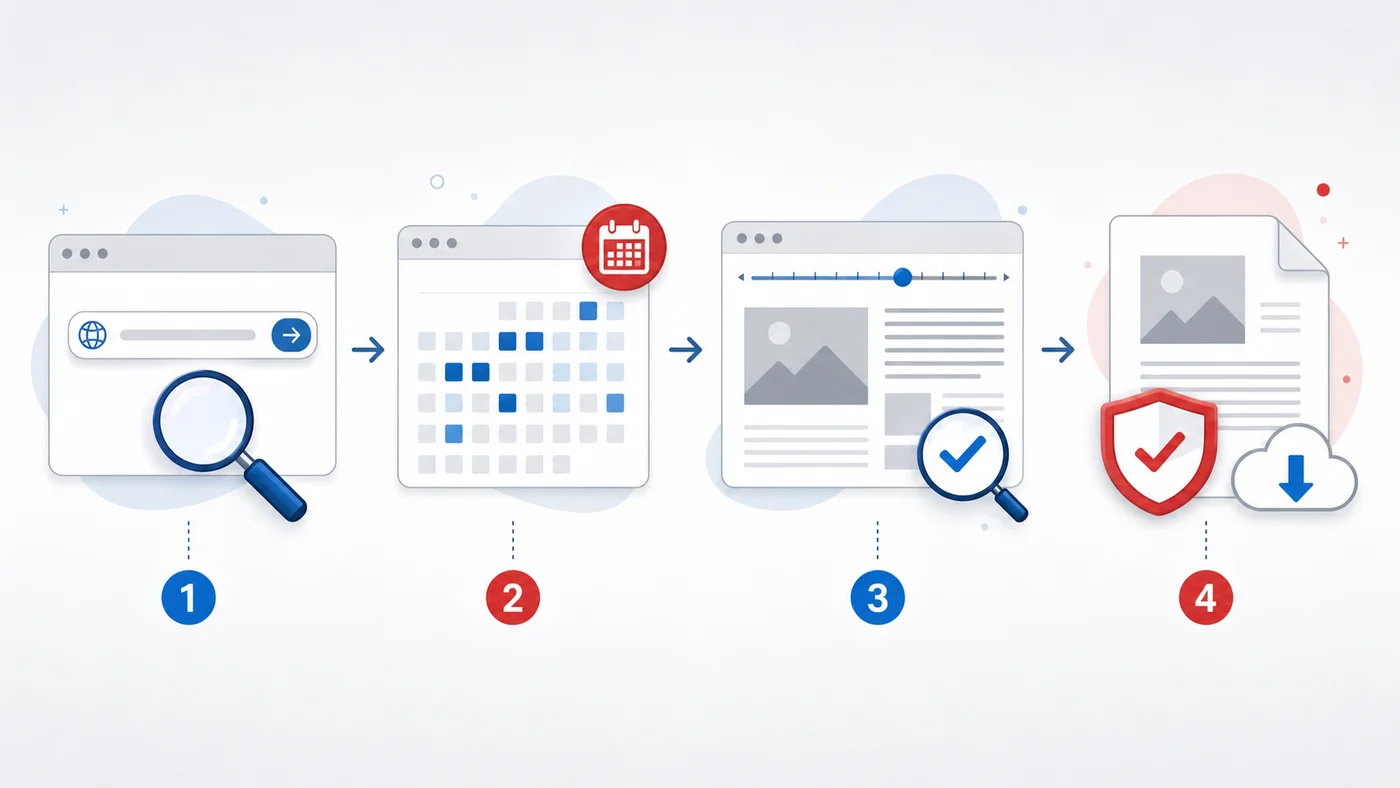
Commencez par chercher l’ancienne adresse exacte du Skyblog, puis collez-la dans Wayback Machine. Testez le pseudo avec les variantes les plus probables, ouvrez le calendrier des captures et privilégiez les dates en bleu. Si aucune capture n’apparaît, essayez une URL plus courte ou un ancien lien trouvé ailleurs.
La clé, c’est l’URL d’origine. Wayback Machine peut aider à retrouver des sites connus par leur adresse, mais il ne lit pas toujours le contenu complet des anciennes pages comme un moteur de recherche moderne. Un pseudo approximatif donnera donc moins de résultats qu’un lien précis.
Pour un Skyblog, essayez notamment le pseudo seul, le pseudo avec l’ancien domaine Skyrock, puis les variantes de pages internes si vous en avez gardé une trace. Un ancien commentaire, une signature de forum, un email ou un lien dans un profil peut suffire à retrouver la bonne porte d’entrée.
Ce que vous avez
Test à faire
Limite possible
Ancienne URL complète
La coller directement dans Wayback Machine
Capture absente ou page incomplète
Pseudo du blog
Tester plusieurs domaines et chemins possibles
Pseudo réutilisé ou mal orthographié
Un vieux lien externe
Ouvrir le lien archivé puis remonter la navigation
Liens internes non capturés
Seulement un nom de personne
Chercher d’abord des traces publiques de l’URL
Résultat incertain et souvent incomplet
Pourquoi certaines pages Skyblog ne s’affichent pas ?
Une capture Wayback n’est pas une sauvegarde parfaite du site. Les robots d’archive devaient avoir accès aux pages au moment du crawl. Si une page était peu liée, bloquée, trop dynamique ou dépendante de fichiers externes, elle peut apparaître vide, cassée ou partiellement chargée.
Les images sont le cas le plus frustrant. Une page peut être archivée avec son texte, mais afficher des cadres gris ou des visuels manquants si les fichiers n’ont pas été collectés. Dans ce cas, cliquez sur les liens d’image quand ils existent et testez-les séparément dans l’archive.
Il faut aussi surveiller la date affichée dans l’URL archivée. Wayback peut remplacer une ressource manquante par une date voisine, ou vous envoyer vers une capture différente de celle choisie. Ce n’est pas forcément une erreur : c’est souvent un signe que l’archive est partielle.
Checklist
Checklist de recherche
✓Noter le pseudo, les anciennes variantes d’orthographe et les éventuels tirets.
✓Tester l’URL complète, puis le domaine seul avec le pseudo.
✓Cliquer sur plusieurs années, pas uniquement sur la dernière capture.
✓Ouvrir les pages internes importantes dans un nouvel onglet archivé.
✓Sauvegarder l’URL Wayback exacte si une capture utile fonctionne.
La recherche fonctionne mieux quand on progresse par URL, dates de capture, pages internes et preuves conservées.
Que faire si vous n’avez plus l’ancienne URL ?
Sans URL, commencez par chercher des traces indirectes. Les anciens forums, profils, commentaires de blogs, pages personnelles, messages copiés ou captures d’écran peuvent contenir l’adresse oubliée. Même un lien tronqué peut aider à retrouver le domaine et le pseudo utilisés à l’époque.
Ensuite, cherchez le pseudo entre guillemets avec des mots comme Skyblog, Skyrock, blog ou le titre supposé de la page. Cette étape sert seulement à retrouver une adresse exploitable, pas à remplacer Wayback Machine. Une fois l’URL trouvée, revenez dans l’archive et testez les dates.
Si le blog a été très peu visité, jamais lié publiquement ou configuré de manière difficile à crawler, il est possible qu’aucune capture publique ne soit disponible. C’est la limite la plus importante : Wayback Machine ne garantit pas la présence d’un ancien Skyblog, même si le blog a bien existé.
Point de vigilance
Évitez les sites qui promettent de récupérer automatiquement tous les Skyblogs. Une vraie récupération dépend d’archives existantes, de vos droits sur le contenu et parfois de démarches hors moteur public.
Wayback Machine ou archive BnF : ce n’est pas le même usage
Wayback Machine sert à consulter des captures publiques accessibles par URL quand elles existent. La BnF, de son côté, a lancé une collecte des Skyblogs dans le cadre du dépôt légal du web français après l’annonce de la fermeture de la plateforme. Cette archive a une logique patrimoniale, avec des conditions d’accès différentes.
D’après la BnF, les archives des Skyblogs sont consultables par des chercheurs accrédités dans ses salles de recherche et dans des bibliothèques partenaires. Elle indique aussi qu’une récupération peut être demandée si l’on détient la paternité et les droits de reproduction du Skyblog concerné.
En pratique, utilisez Wayback Machine pour une consultation rapide, surtout si vous avez une URL. Si vous cherchez une récupération plus complète, ou si le contenu vous appartient, regardez plutôt la piste BnF. Les deux chemins peuvent se compléter, mais ils ne répondent pas au même besoin.
La bonne méthode pour garder une preuve
Quand vous trouvez une capture exploitable, copiez l’URL archivée complète, avec le code de date. Notez aussi l’URL d’origine, l’année de capture et ce que la page contient réellement. Une simple capture d’écran isolée est moins utile qu’un ensemble clair : adresse, date, contexte et page consultée.
Pour un souvenir personnel, cela suffit souvent. Pour un usage sérieux, une republication ou une demande officielle, vérifiez vos droits avant de réutiliser les contenus. Un ancien Skyblog peut contenir des photos, commentaires ou informations impliquant d’autres personnes. La prudence reste nécessaire, même quand l’archive est visible.
La conclusion est simple : Wayback Machine est le premier outil à essayer pour un Skyblog, mais il réussit surtout quand vous retrouvez l’ancienne URL. Sans adresse précise, la recherche devient possible, mais beaucoup plus incertaine.
Questions fréquentes
Oui, mais seulement si l’URL a été capturée avant la disparition du blog. L’outil peut afficher une page partielle, sans toutes les images ni toutes les pages internes.
Le pseudo exact aide beaucoup, surtout s’il permet de reconstruire l’ancienne URL. Sans pseudo ou lien, il faut d’abord chercher des traces externes avant d’utiliser Wayback Machine.
Les fichiers image n’ont pas forcément été archivés avec la page. Il peut aussi manquer des ressources externes ou des scripts nécessaires à l’affichage complet.
Non. La BnF conserve une archive patrimoniale avec des conditions d’accès spécifiques. Wayback Machine reste plus simple pour tester rapidement une URL publique capturée.
Lina Rivière s'intéresse à la cybersécurité et partage ses découvertes pour aider le grand public et les PME à mieux se protéger. Elle assure une veille permanente sur le…
Envoyer un gros fichier ne consiste pas seulement à trouver un lien qui marche. Le bon choix dépend de la taille, de l'urgence, de la confidentialité et du suivi attendu.
Un outil gratuit suffit parfois pour lancer un site, mais pas pour tous les projets. Le bon choix dépend du domaine, du design, du contenu, du SEO et du moment où il faudra évoluer.



 · ·19 min